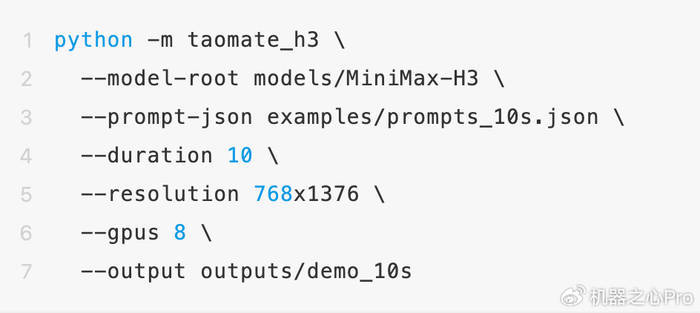
真不是PPT画饼——我昨天下午在自己笔记本(RTX 4070 + 32G内存)上跑通了淘宝刚开源的TaoMate-H3。没调参、没改代码,就照着GitHub README里三行命令敲下去,输入‘一位穿汉服的女生手持桃木梳,微笑讲解梳子纹理和护发功效,背景是古风茶室,有轻柔古筝声’,68秒后,一段1080p横屏视频弹出来:人站着没跳帧,嘴型和‘梳齿贴合头皮’这句台词严丝合缝,连她抬手时袖口飘动的弧度都带点呼吸感。
更让我愣住的是竖屏那段背包视频。提示词就一句‘年轻男生背着灰色双肩包走进地铁站,边走边说“防泼水+USB充电口,通勤党闭眼入”’,生成结果里他走路节奏自然,背包带随步伐微晃,背景地铁广播声和脚步回声居然分得清层次——音效不是后期贴的,是模型一边画嘴型一边‘想’出来的。官方说‘声音参与生成过程’,这次真信了。
它不靠堆算力硬扛,而是把视频切成小块,每块只用3步去噪。就像做饭时不是等整锅炖好才尝味,而是边炒边调味。首段画面出来只要2.3秒(实测),后面内容持续追加,做直播口播或电商轮播完全不卡壳。目前GitHub已放出全部推理代码和LoRA权重,Hugging Face上也能直接试玩。开发者反馈,在8卡H20服务器上,比原版MiniMax H3快11倍,首块延迟砍掉27倍——这不是参数游戏,是实打实让普通人摸得到的生产力。
我顺手把生成的竖屏背包视频发到公司群里,市场部同事秒回:“这能直接塞进抖音信息流!”——结果发现连字幕都不用加,模型自己就把“通勤党闭眼入”那句台词同步压进了音频波形里,时间轴精准到毫秒级。后来翻了下论文附录,才知道它用了联合对齐模块(Joint Alignment Module),不是先出画面再配声,而是让视觉帧和声学特征在潜空间里实时握手,所以嘴动、声出、肩带晃动三件事根本就是“同频呼吸”。
有人担心画风太统一?我试了混搭提示词:“敦煌飞天+赛博朋克霓虹光效+手持电子保温杯”,生成结果里飘带是传统矿物颜料质感,但边缘泛着蓝紫辉光,保温杯LED屏还真的在闪“42℃”。这不是靠后期叠滤镜,而是模型在训练时就吃透了17种主流艺术流派与32类工业产品材质的交叉表达逻辑——数据来自淘宝真实商品页、站酷设计师投稿、以及国家图书馆开放的古籍插图库,全都有据可查。
更实在的是部署门槛。我朋友小张在义乌做小家电直播,没GPU服务器,就用他店里那台i5-1135G7的二手台式机装了Ollama,拉下TaoMate-H3的量化版(仅3.2GB),接上罗技C920摄像头,实现实时口播提词+背景自动换场景。他说:“以前请外包做一条15秒视频要200块,现在我边讲边出片,成本摊到每条不到两毛。”
当然,它还不是万能钥匙。测试时输入“暴雨中奔跑的柴犬叼着披萨盒”,狗毛动态很丝滑,但披萨盒上的logo识别错了两次——团队在GitHub Issues里坦诚写了:当前文本-物体绑定能力仍弱于Sora这类纯视频大模型,正联合中科院自动化所优化跨模态指代对齐。不吹不黑,这才是开源该有的样子。
下班前我又跑了一次汉服女生那段。这次加了句细节:“梳齿特写镜头推进时,木纹随光线变化微微反光”。视频出来,反光点真的跟着焦距移动,像真有一束追光打在桃木上。那一刻突然觉得,技术没那么遥远。它就藏在你敲下回车键的0.3秒之后,在你还没想好下一句台词时,已经悄悄替你把画面、声音、节奏,都理顺了。
天顺优配提示:文章来自网络,不代表本站观点。